
(jason3e7 的直覺)LLM 就是統計學。
這句話是對的,而且比多數人以為的更「字面」。
1948 年,Claude Shannon 在《A Mathematical Theory of Communication》裡做了一個實驗:他想知道英文到底有多可預測。做法很土 - 翻書、數字母,統計哪兩個字母常黏在一起,然後照這個機率一個一個抽出來。抽到第三層(每個字接前一個字的機率)時,他得到這樣一串東西:
THE HEAD AND IN FRONTAL ATTACK ON AN ENGLISH WRITER THAT THE CHARACTER OF THIS POINT IS THEREFORE ANOTHER METHOD FOR THE LETTERS THAT THE TIME OF WHO EVER TOLD THE PROBLEM FOR AN UNEXPECTED
它不是英文,但已經很像英文。Shannon 沒有教它任何文法,他只統計了「哪個字後面常出現哪個字」。那是 1948 年,他只能靠手翻書,所以停在這裡。
今天的大型語言模型(LLM)做的是同一件事,只是把三個地方推到極端:能看多長的前文、統計得多細、吃了多少資料。
用一句話說完模型的工作:
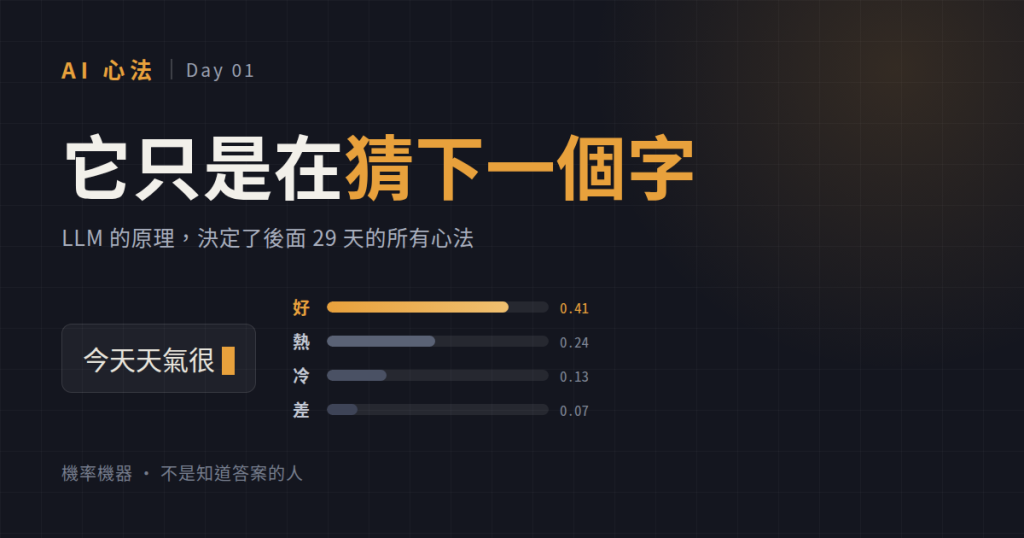
看完前面所有的字 → 輸出「下一個 token 各自有多少機率」 → 抽一個出來 → 把它接到後面,再做一次。
沒有第二個動作了。你看到的那些長篇大論、程式碼、分析報告,都是這個動作重複幾千次的結果。
補充:Token 是模型眼中的最小單位,不完全等於「字」。大約 0.75 個英文單字 ≈ 1 token,中文 1 個字 ≈ 1–2 tokens。
理解了這件事,兩個最常見的疑問就有答案了:
第二點有實證。OpenAI 在 2025 年的論文《Why Language Models Hallucinate》講得很直白:幻覺的起點只是二元分類的錯誤;而它為什麼一直存在,是因為主流評測用準確率打分,猜對加分,猜錯扣的分跟老實說「不知道」一樣多,那當然要猜。 他們開的處方也很直接:對「有自信的錯」要罰得比「承認不確定」更重。
換句話說:幻覺不是壞掉了,是統計目標加上評分方式的必然產物。
(jason3e7 的直覺)沒學過的,是不會的。
對的那一半: 訓練資料裡沒有的事實,它真的不知道。知識截止日(knowledge cutoff)是一道硬邊界,問它昨天發生的事,它只能編。這也是 RAG(檢索增強生成)存在的唯一理由:把它沒學過的東西,塞進當下的脈絡裡給它看。
要修的那一半: 沒看過一樣的題目,它也常常答得出來,就像學生沒寫過這題,也能用學過的觀念解。但它根本不知道的事,就答不出來,只會編一個聽起來很像的答案。有兩個實驗可以說明。
一、Othello-GPT(Li et al., 2022)。
想像你只看得到一長串棋譜,像是「黑下這裡、白下那裡」,從頭到尾沒看過棋盤,也沒人告訴你規則。你唯一的任務是猜下一手會下在哪。
2022 年有一組研究者就是這樣訓練一個小模型的(用的是黑白棋)。訓練完把模型剖開來看,發現它自己在腦中畫出了一張棋盤:哪一格是黑、哪一格是白、哪一格還空著,都對得上。
更關鍵的是下一步。研究者直接動手改它腦中那張棋盤,把某一格的黑子換成白子。結果模型接下來猜的棋步,就照著被改過的盤面走。
它不是在背棋譜,它真的建了一個「這盤棋現在長什麼樣」的模型。 而它學到這件事,靠的只是一直猜下一手。
二、Anthropic 的《On the Biology of a Large Language Model》(2025)。
2025 年 Anthropic 用了一種類似腦部掃描的方法,觀察 Claude 回答問題的當下,內部哪些部位被點亮。三個發現:
所以更準確的講法是:
它會的是「重組與內插」,不是「背誦」。它把學過的東西重新組起來,所以能解沒見過的題;但它根本不知道的事,就答不出來,只會編一個聽起來很像的答案。
這兩個實驗合起來,剛好回答了 2021 年一篇很有名的批評。
那篇〈On the Dangers of Stochastic Parrots〉把語言模型比喻成「隨機鸚鵡」 - 只會把看過的話重新吐出來,自己什麼都不懂。今天回頭看,這個比喻要拆成兩半:它對偏見與過度炒作的批評,現在仍然成立;但「模型內部什麼都沒有、只是表面統計」這個說法,已經被上面兩個實驗推翻了。
不過反方向的說法也別照單全收。2023 年另一篇研究指出:很多「模型一變大,某個能力就突然冒出來」的驚人曲線,其實是計分方式造成的錯覺,原本用「整題全對才給分」,換成「對幾成給幾分」,那條陡然拉起的線就變回一條緩坡。
兩邊都別全相信。 這件事本身,就是後面會反覆用到的心法。
今天只要記住一句話:
你不是在跟一個知道答案的人講話,你是在跟一個非常會接話的機率機器講話。


 iThome鐵人賽
 看影片追技術